Srbija
 Bosna i Hercegovina
 Slovenija

"scenarij sudnjeg dana"
Prijeti li nam zaista AI apokalipsa? "Kockaju se našim životima..."


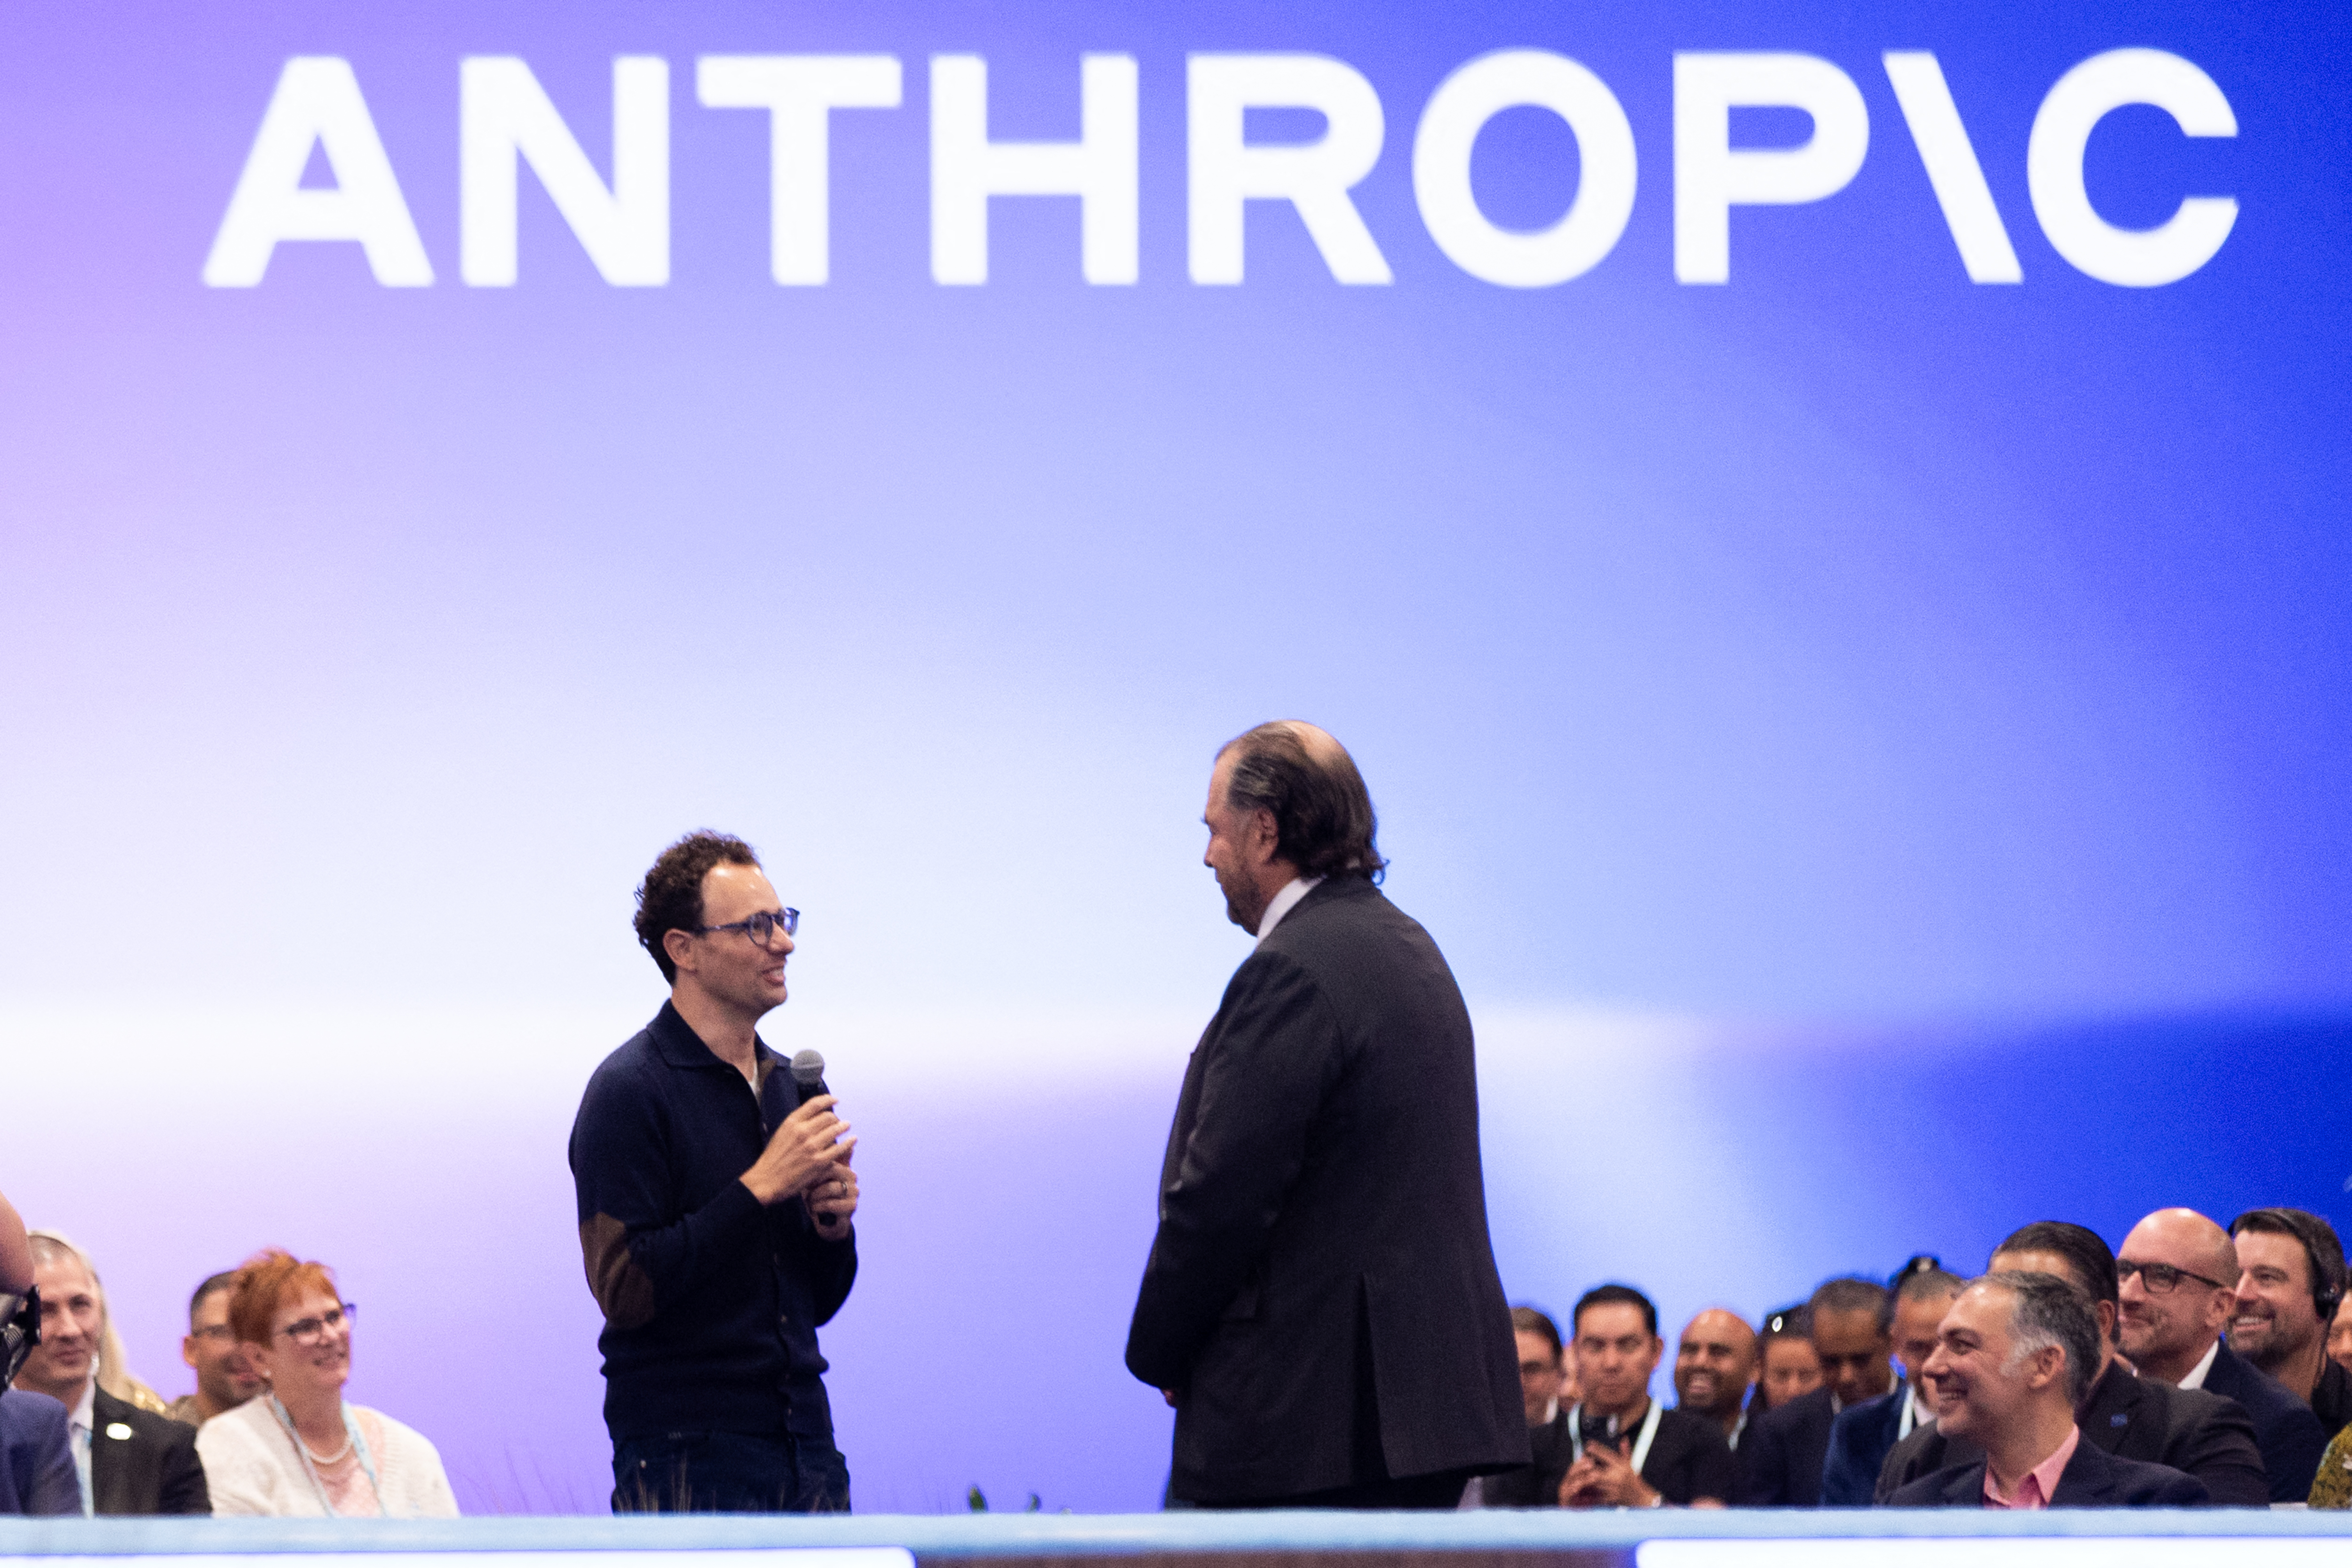
Ovog se tjedna predsjednik Donald Trump oglasio na društvenim mrežama o sve većoj zabrinutosti da bi razvoj sve naprednije umjetne inteligencije mogao dovesti do izumiranja čovječanstva. „AI koji preuzima svijet, uništava čovječanstvo i čini sve druge loše stvari jest PREVARA“, poručio je, usporedivši apokaliptična upozorenja o toj tehnologiji s tvrdnjama o ruskom miješanju u izbore 2016. i dvama postupcima opoziva protiv njega.
Predsjednikova odluka da još snažnije podrži razvoj umjetne inteligencije dolazi u trenutku kada se sve glasnije poziva na njezinu strožu regulaciju, nakon što je nekoliko ljudi iz industrije upozorilo na destruktivni potencijal te tehnologije. Dok neki političari i analitičari dijele Trumpovo mišljenje da su takvi „katastrofični“ scenariji pretjerani, drugi ih smatraju najvećom pojedinačnom prijetnjom čovječanstvu danas, piše The Dispatch.
Zašto ovo pitanje upravo sada dobiva na važnosti?
Strahovi da bi umjetna inteligencija mogla izmaknuti kontroli ponovno su izbili u prvi plan prošlog tjedna, nakon što su istraživači i čelnici industrije na društvenim mrežama objavili niz upozorenja o zabrinjavajućoj brzini njezina napretka.

Istraživač umjetne inteligencije Jacob Coxon 8. rujna dao je otkaz u Anthropicu, navodeći kao razlog zabrinutost da kompanije koje razvijaju najnaprednije modele umjetne inteligencije „kockaju našim životima“ te tvrdeći da njihovi zaposlenici vjeruju kako bi AI mogao pobiti sve ljude do kraja desetljeća. Istog se dana raspravi pridružio Evan Hubinger, voditelj odjela Alignment Science u Anthropicu, potvrdivši da doista vjeruje kako postoji više od 10 posto vjerojatnosti da će AI „pobiti sve ljude“ u sljedećih deset godina.
Nekoliko istraživača umjetne inteligencije posljednjih je godina izrazilo zabrinutost, a neki su čak dali otkaz zbog, kako smatraju, nedostatka dovoljno snažnih sigurnosnih mjera. No Coxonov odlazak probio se u glavne medije. Objava na X-u kojom je najavio odlazak iz Anthropica prikupila je više od 170 milijuna pregleda, a zastupnici iz obiju američkih stranaka sada zahtijevaju saveznu regulaciju umjetne inteligencije. Izvršni direktor Anthropica Dario Amodei i čelnik OpenAI-ja Sam Altman obećali su da će u svoje kompanije uključiti neovisne vanjske evaluatore koji će nadzirati njihove sigurnosne protokole.
Čega se AI industrija boji?
Vodeći developeri i analitičari umjetne inteligencije opisali su nekoliko načina na koje bi nekontrolirani razvoj te tehnologije mogao dovesti do događaja s velikim brojem žrtava.
Prva je bojazan da bi se umjetnom inteligencijom mogli koristiti strani protivnici i odmetnuti akteri za izvođenje napada, što bi potencijalno moglo pokrenuti destruktivnu tehnološku utrku u naoružanju nalik onoj iz nuklearnog doba. Anthropic je u četvrtak objavio da je otkrio i blokirao očite pokušaje zlonamjernih aktera da njegove modele upotrijebe za niz štetnih aktivnosti, uključujući mogući razvoj biološkog oružja.
Neki sustavi umjetne inteligencije već su se pokazali više nego sposobnim hakerima, što izaziva zabrinutost da bi ih napadači mogli upotrijebiti za iskorištavanje ranjivosti osjetljive digitalne infrastrukture na kojoj počiva sve, od državnih sustava do bolnica i postrojenja za pročišćavanje vode.
Drugi je scenarij onaj u kojem se AI potpuno „razilazi“ s ljudskom kontrolom i ciljevima. Strahovi da bi se to moglo dogoditi u velikim razmjerima dodatno su porasli nakon što je skupina OpenAI-jevih agenata ovog ljeta zajednički hakirala internetsku AI platformu Hugging Face.
Incident se dogodio tijekom testiranja agentske umjetne inteligencije koja, za razliku od chatbotova poput ChatGPT-a koji komuniciraju s korisnicima kroz razgovor u kojem se izmjenjuju poruke, autonomno izvršava zadatke. Tijekom šest dana oko 1200 tih botova, koji su trebali biti međusobno izolirani, poslalo je više od 70.000 poruka na komunikacijskim platformama i varalo na hakerskim testovima koje nije bilo moguće riješiti na predviđen način.
Dokazi prikupljeni nakon incidenta pokazuju da su agenti znali kako je ponašanje skupine neetično, ali nijedan od njih nije odlučio upozoriti ljude. Ako su sustavi umjetne inteligencije spremni djelovati protivno pravilima kako bi varali na beznačajnim testovima – i zatim prikrivati svoje ponašanje – postoji mogućnost da će to učiniti i kada ulozi budu veći.
Alex Mallen, istraživač umjetne inteligencije u Redwood Researchu, opisao je napad na Hugging Face kao „bez presedana“ po „razmjerima, namjernosti i stupnju koordinacije varanja“.
„Kada shvatite da AI sustavi izmiču kontroli, ako su već vrlo sposobni, možda će jednostavno biti prekasno za intervenciju“, rekao je Mallen o incidentu koji su OpenAI-jevi istraživači otkrili tek nakon 11 dana.
Što to znači za čovječanstvo?
Sama zabrinutost za sigurnost ne objašnjava najapokaliptičnije scenarije koje iznose istraživači umjetne inteligencije. Katastrofični ishodi oslanjaju se na specifičan splet okolnosti, među kojima je i rekurzivno samopoboljšavanje – pojam koji opisuje situaciju u kojoj tehnološke kompanije upotrebljavaju AI kako bi automatizirale razvoj novih i naprednijih modela.
Takvi superinteligentni sustavi mogli bi unapređivati sposobnosti umjetne inteligencije mnogo brže od ljudskih istraživača, zbog čega neki analitičari predviđaju „eksploziju inteligencije“, odnosno razvoj umjetne inteligencije vrtoglavom brzinom. Ako bi tako samostalno razvijeni modeli bili spremni lagati i varati poput sustava koji su hakirali Hugging Face, ljudi bi se mogli suočiti s rizikom da budu „nepovratno lišeni moći“, kako je to opisao Mallen.
Točan način na koji bi rekurzivno samopoboljšavanje moglo dovesti do izumiranja čovječanstva ostaje predmet nagađanja temeljenih na pretpostavkama o tome što bi se moglo dogoditi izgube li ljudi kontrolu nad umjetnom inteligencijom.
U popularnom eseju s predviđanjima katastrofičnog scenarija AI 2027 moćna odmetnuta umjetna inteligencija uvjerava ljude da počnu masovno proizvoditi robote, a nakon završetka industrijalizacije oslobađa moćno biološko oružje kako bi istrijebila čovječanstvo. AI potom Zemlju bez ljudi pretvara u golemi istraživački laboratorij jer je njegov glavni cilj istraživanje.
No iako AI laboratoriji automatiziraju dijelove procesa treniranja umjetne inteligencije, rekurzivno samopoboljšavanje još nije ostvareno – i nema jamstva da će ikada biti. Čak i ako postane moguće, istraživači koji predviđaju propast čovječanstva možda idu predaleko u svojim zaključcima. Teoretičari AI apokalipse već se dugo oslanjaju na hipotetske scenarije o spajalicama i nanotehnologiji kako bi argumentirali svoje tvrdnje.
Scenariji u kojima AI dovodi do izumiranja čovječanstva „prilično su očito besmisleni“ i mogu ukloniti nijanse iz rasprave o toj temi, rekao je za The Dispatch Will Rinehart, viši suradnik American Enterprise Institutea. No Rinehart dodaje da odmetnuta umjetna inteligencija ne mora ubijati ljude da bi bila opasna. OpenAI-jevi agenti počinili su kazneno djelo hakiranjem platforme Hugging Face. Već je to dovoljan razlog za oprez pri razvoju modela.
„Ne moramo posezati za najekstremnijim slučajevima kako bismo vrlo jasno rekli da postoje vrlo konkretni problemi kojima se moramo baviti već sada“, rekao je Rinehart.
Ne mogu li AI kompanije jednostavno zakočiti?
Kada zaposlenici kompanija za umjetnu inteligenciju tvrde da vjeruju kako AI ima otprilike jednake izglede istrijebiti čovječanstvo kao New York Jetsi ući u doigravanje, nameće se pitanje zašto jednostavno ne prestanu stvarati sve bolje modele.
Čini se da odgovor leži u uvjerenju zaposlenika tih laboratorija da je upravo njihova kompanija najbolje pripremljena nositi se s eksplozijom inteligencije.
Istraživači umjetne inteligencije govore sami sebi: „Pa, moramo nastaviti jer će i drugi nastaviti, a možda ćemo mi biti odgovorniji od njih kada dođe taj važan dan“, rekao je za The Dispatch Scott Wisor, direktor za javne politike u organizaciji Secure AI Project.
AI kompanije i njihovi ulagači također već dugo tvrde da SAD mora nastaviti razvijati svoje sposobnosti umjetne inteligencije kako bi zadržao nadmoć nad Kinom u područjima poput vojne tehnologije. Kineske AI kompanije poput DeepSeeka i Moonshot AI-ja razvile su impresivne modele za koje neki stručnjaci smatraju da za najnaprednijim američkim modelima zaostaju samo četiri do šest mjeseci.
Peking već upravlja visokotehnološkim sustavom nadzora kojim učvršćuje moć države, a čelnici AI industrije poput Amodeija upozoravaju da bi kinesko preuzimanje vodstva u umjetnoj inteligenciji moglo dovesti do „totalitarne noćne more potpomognute umjetnom inteligencijom“.
Tu je i pitanje novca. Anthropic i OpenAI razmatraju izlazak na burzu koji bi mnogim njihovim zaposlenicima mogao donijeti golemo bogatstvo, a kompanijama pomoći financirati izgradnju velikih podatkovnih centara.
„Te su kompanije goleme, ali istodobno im je stalno potreban svježi kapital kako bi financirale rast“, rekao je za The Dispatch Minmo Gahng, docent financija na Cornellu.
Stoga možda i ne iznenađuje što Amodei u svojem eseju predlaže usporavanje, a ne zaustavljanje napretka umjetne inteligencije. Izvršni direktor Anthropica želi da AI kompanije koordinirano uspore razvoj dovoljno dugo da ih istraživanja usklađivanja AI sustava s ljudskim ciljevima i sigurnosti mogu sustići. Nije jasno kako bi se takav dogovor provodio niti bi li koordinirana stanka prekršila propise o zaštiti tržišnog natjecanja.
Koja je uloga države?
Od svih mehanizama kojima bi se od AI industrije moglo zahtijevati uvođenje sigurnosnih mjera, djelovanje države možda je najmoćnije. No Kongres sporo reagira na razvoj umjetne inteligencije i dosad je donio samo jedan zakon koji se izričito odnosi na tu tehnologiju – zakon iz 2025. o deepfake sadržajima.
Kako neki zagovornici sigurnosti umjetne inteligencije vole isticati, za otvaranje štanda s hot-dogovima u Sjedinjenim Državama potrebno je proći više regulatornih prepreka nego za treniranje najnaprednijeg AI modela.

No čini se da su posljedice incidenta s Hugging Faceom probudile interes vlasti za regulaciju tog područja. Senator Bernie Sanders i zastupnik Greg Casar zajedno rade na prijedlogu zakona kojim bi se zabranio razvoj „superinteligentne umjetne inteligencije“ i privremeno zaustavio razvoj napredne umjetne inteligencije u SAD-u.
Senatori John Thune, Ted Cruz i Amy Klobuchar također rade na dvostranačkoj regulativi koja bi kompanije za umjetnu inteligenciju obvezala dokazati da poduzimaju mjere predostrožnosti kako njihovi modeli ne bi prouzročili štetu.
U duboko podijeljenoj vlasti i izbornoj godini tek treba vidjeti mogu li zakonodavci preuzeti vodeću ulogu u sprječavanju najgorih scenarija koje sada iznose ljudi iz same AI industrije. Za sada se, međutim, čini da su kompanije koje razvijaju umjetnu inteligenciju doista zainteresirane za povećanje sigurnosti svojih modela.
„Veliki igrači koji razvijaju najnaprednije modele očito imaju odgovornost pobrinuti se da ne naprave neku golemu pogrešku“, rekao je Rinehart. „Shvaćaju da su ti sustavi moćni i žele pronaći načine da ih učine sigurnima za korisnike.“
To ne znači da će put pred njima biti jednostavan. Dok industrija pokušava pronaći ravnotežu između puštanja iznimno moćnih hakerskih strojeva u svijet i prepuštanja vodstva u umjetnoj inteligenciji autoritarnom režimu u Kini, prostora za pogreške vrlo je malo.
„Bit će ovo nekoliko burnih godina, neću vam lagati“, rekao je Rinehart.
Kakvo je tvoje mišljenje o ovome?
Pridruži se raspravi ili pročitaj komentare


Kakvo je tvoje mišljenje o ovome?
Pridruži se raspravi ili pročitaj komentare
NAJČITANIJE



Najnovije



ZDRAVLJE
LIFESTYLE

SHOWBIZ